ITSM-Bottleneck-Analyse: verborgene Incident-Delays
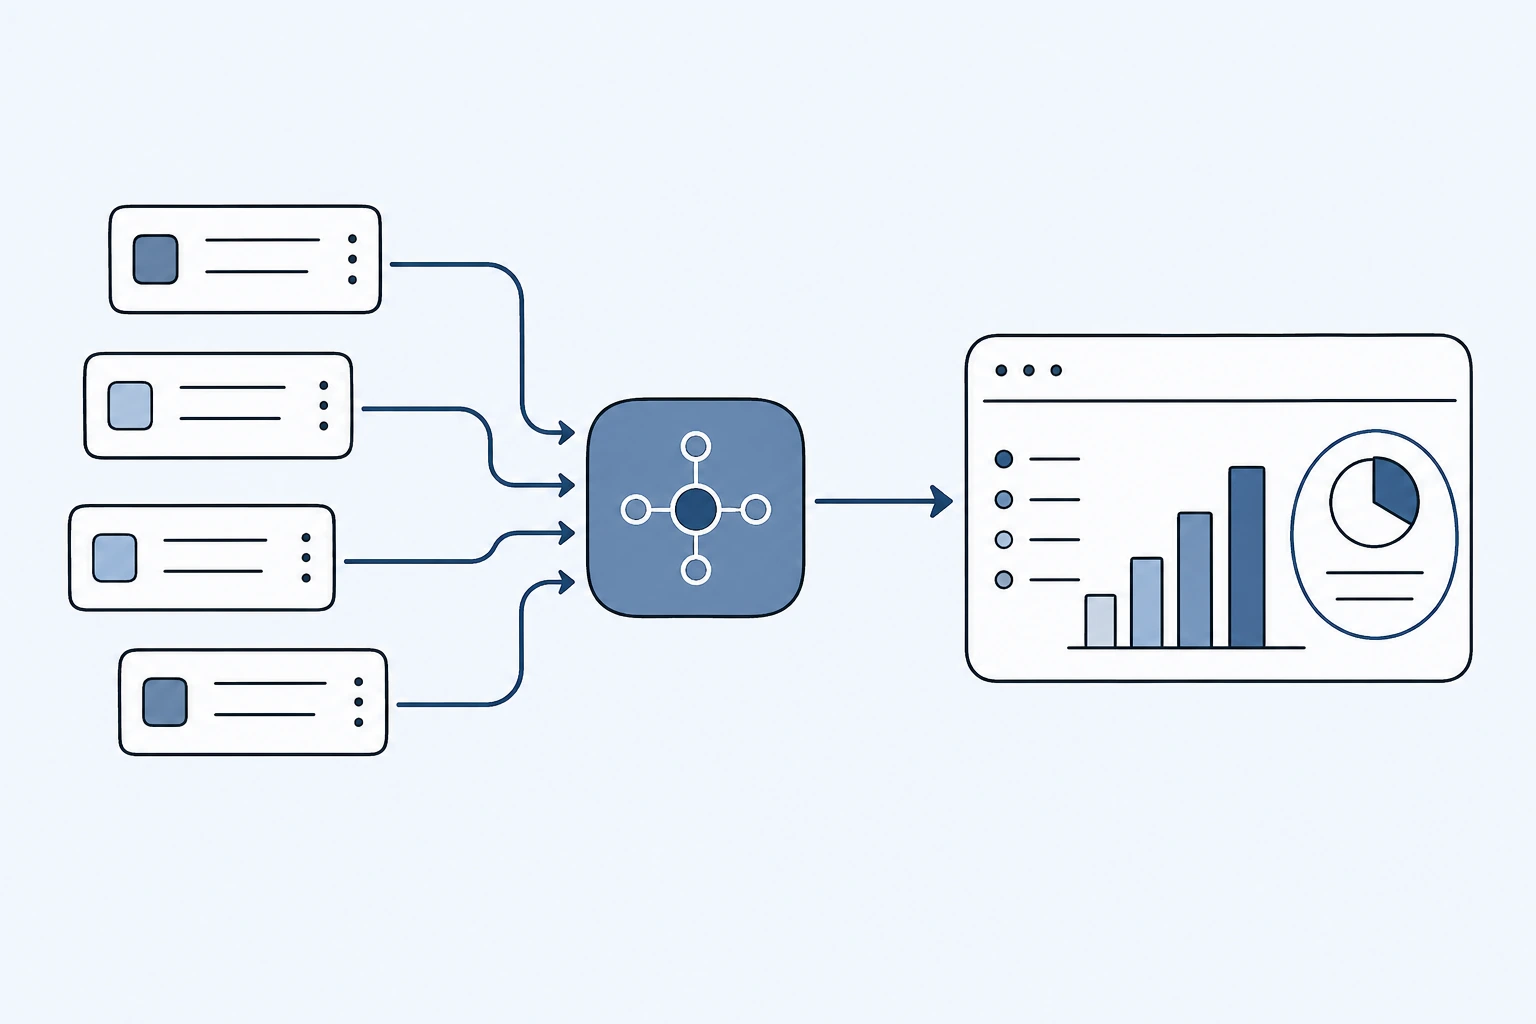
Verborgene Engpässe im Incident-Flow erkennt man selten in einer einzigen offensichtlichen Queue. Sie zeigen sich eher als wiederholte Übergaben, unklare Zuständigkeiten und stille Alterung, die in gemischten SLA-Berichten untergeht.
Wenn man Weiterleitungsschleifen, Queue-zu-Queue-Wechsel und Alterung nach Service-Grenzen isoliert, wird die eigentliche Reibung sichtbar. Genau dort wird aus ITSM-Reporting ein operativer Entscheidungs-Backlog statt nur ein weiteres Dashboard.
Warum normale ITSM-Reports Engpässe übersehen
Die meisten Service-Desk-Teams haben bereits Dashboards. Sie sehen Ticketvolumen, SLA-Verletzungen, durchschnittliche Lösungszeiten und offene Backlogs. Diese Kennzahlen sind hilfreich, beschreiben aber oft nur das Symptom.
Der eigentliche Engpass liegt meist eine Ebene tiefer. Eine Queue kann selbst schnell arbeiten, obwohl Tickets vorher lange in einer anderen Gruppe lagen. Ein Resolver-Team kann gute Bearbeitungszeiten haben, aber regelmäßig falsch geroutete Tickets erhalten. Eine Kategorie kann im Durchschnitt gesund wirken, während eine bestimmte Übergabe den größten Teil der Wartezeit erzeugt.
Darum muss eine ITSM-Bottleneck-Analyse den Weg des Tickets erhalten, nicht nur den finalen Status.
Welche Exportfelder wichtig sind
Ein brauchbarer Incident-Export sollte Ticket-ID, Eröffnungs- und Lösungszeitpunkt, Assignment Groups, Priorität, Kategorie, Kurzbeschreibung, Lösungsnotizen und Statushistorie enthalten. Fehlt die Statushistorie, zeigen Assignment-Änderungen und Update-Zeitpunkte zumindest, wo Arbeit wiederholt weitergegeben wird.
Prüfen Sie getrennt:
- Wartezeit in der Queue
- aktive Bearbeitungszeit je Resolver-Gruppe
- Anzahl der Weiterleitungen
- Reopens
- Alterung nach Kategorie und Service-Familie
- wiederkehrende Muster in Kurzbeschreibungen
Diese Trennung ist wichtig, weil jede Verzögerung eine andere Maßnahme braucht. Queue-Zeit kann Routing oder Kapazität bedeuten. Weiterleitungsdrag deutet auf Ownership-Probleme. Wiederkehrende Nachfrage kann Prävention, Automatisierung oder Knowledge-Arbeit auslösen.
Was Führungskräfte brauchen
Das Ergebnis sollte keine größere Tabelle sein. Es sollte eine priorisierte Entscheidungsansicht sein:
- Welche Assignment Groups erzeugen die meiste Verzögerung?
- Welche Übergaben wiederholen sich oft genug, um sie zu beheben?
- Welche Ticketfamilien gehören ins Problem Management?
- Welche Muster eignen sich für Prävention oder Auto-Resolution?
- Was sollte in den nächsten 90 Tagen finanziert werden?
Die Seite zur ServiceNow Performance Analytics Alternative folgt genau diesem Gedanken: Der Wert liegt nicht in mehr Charts, sondern in Entscheidungen, die mit Evidenz begründet sind.
Ein einfacher Bewertungsrahmen
Bewerten Sie jeden Engpass nach vier Kriterien:
- Impact: wie viel Volumen oder Zeit am Muster hängt.
- Konzentration: ob das Problem klar genug einem Owner zugeordnet werden kann.
- Behebbarkeit: ob Routing, Knowledge, Automatisierung oder Prozessarbeit helfen.
- Sicherheit: ob der Export genug Evidenz für die Empfehlung enthält.
Die besten ersten Maßnahmen sind nicht immer die größten Queues. Es sind die Muster mit genug Wirkung, klarer Ownership und belastbarer Evidenz.
Wie das in den Diagnostic Sprint passt
Der Diagnostic Sprint beginnt mit derselben Frage: Wo geht Zeit verloren, und was sollte Leadership zuerst beheben? Wenn der Export genug Assignment-, Zeitstempel- und Kategoriehistorie enthält, entsteht daraus innerhalb von 5 Arbeitstagen ein Entscheidungs-Paket.
Ist der Export unvollständig, ist auch das ein Ergebnis. Dann ist die erste Empfehlung vielleicht Datenbereitschaft: Statushistorie ergänzen, Assignment Groups normalisieren oder Incidents und Tasks sauber trennen.