Incident Management Analytics für wiederkehrende Incidents
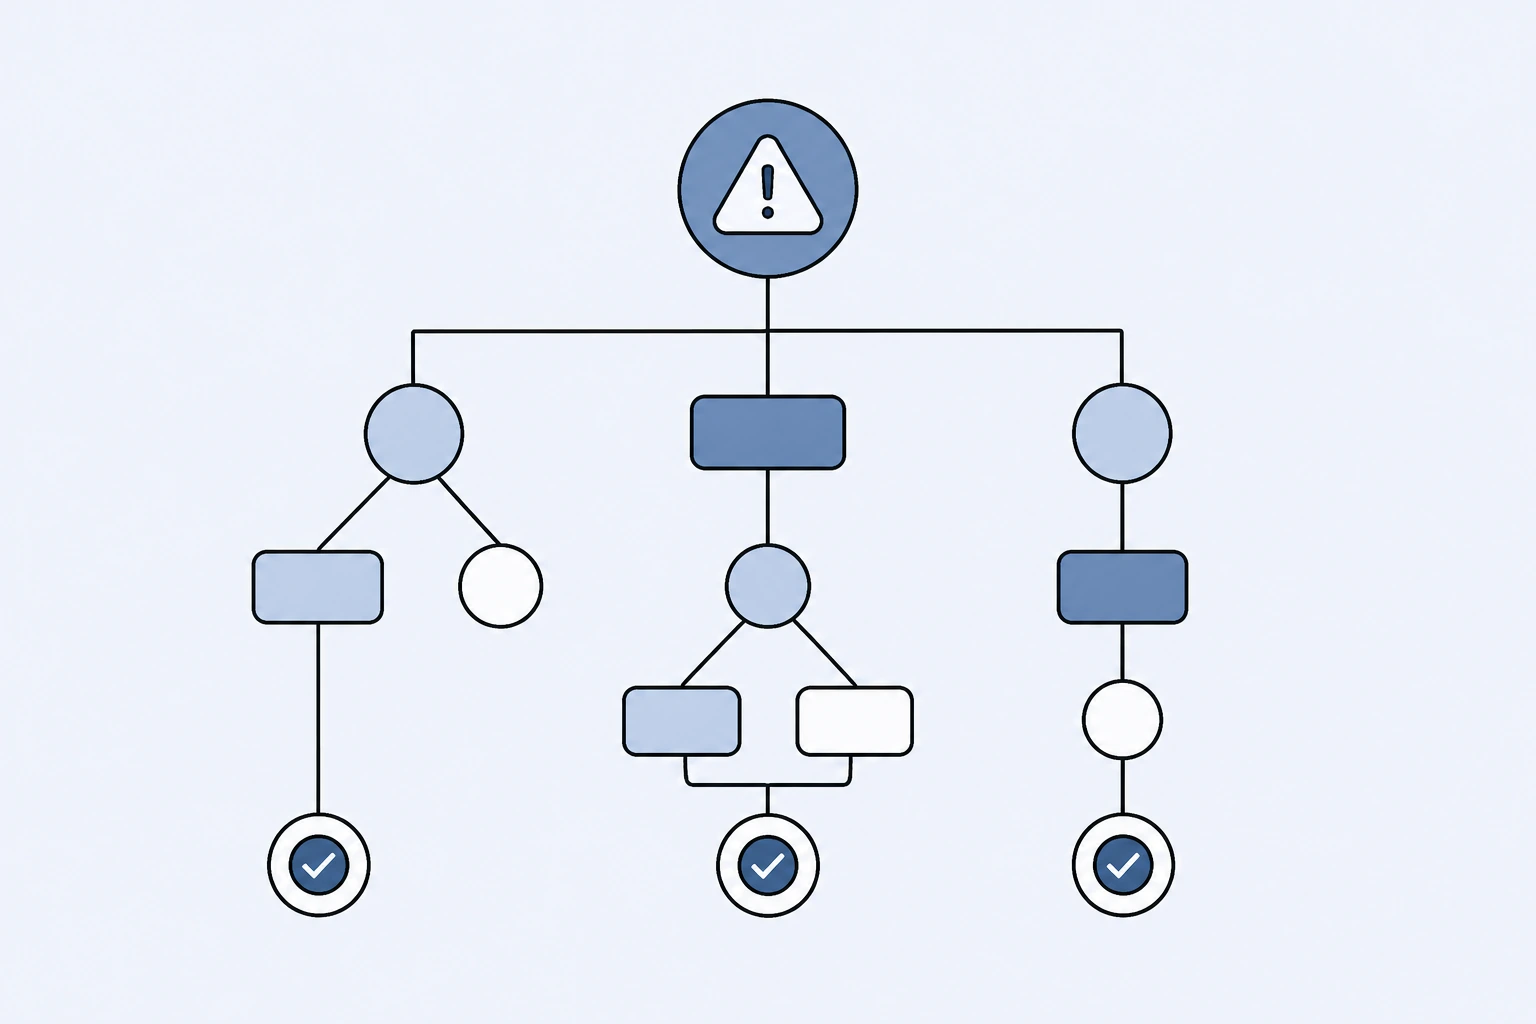
Wiederkehrende Incidents sollten nicht im operativen Reporting stecken bleiben. Mit Incident Management Analytics werden sie zu einem klaren Beleg dafür, dass Nachfragemuster wiederholbar sind und Präventionsarbeit sicherer priorisiert werden kann.
Wenn wiederholte Tickets nach Thema, Auswirkung und betroffenem Service-Bereich gruppiert werden, wird Problem Management messbar. Genau so verbindet ITSM-Analytics operativen Support, Knowledge-Arbeit und strukturelle Verbesserung.
Warum wiederkehrende Incidents unsichtbar bleiben
Viele Teams wissen, dass sie wiederkehrende Incidents haben. Was fehlt, ist eine belastbare Rangfolge: Welche Muster verdienen Problem-Management-Aufmerksamkeit, welche gehören in Knowledge, und welche eignen sich für Automatisierung?
Das Signal liegt verteilt in Kurzbeschreibungen, Kategorien, Assignment Groups, Lösungsnotizen und Reopens. Volumen allein reicht nicht. Ein häufiges Passwortproblem kann automatisierbar sein. Ein selteneres Applikationsmuster kann trotzdem ein formales Problem Record verdienen.
Welche Daten für Pattern Clustering gebraucht werden
Startpunkt ist ein sauberer Incident-Export. Mindestens hilfreich sind Ticket-ID, Eröffnungs- und Lösungszeitpunkt, Priorität, Kategorie, Assignment Group, Kurzbeschreibung, Lösungsnotizen und Close Code. Verknüpfte Problem Records helfen, sind aber nicht zwingend.
Gruppieren Sie Incidents nach wiederkehrenden operativen Signaturen:
- ähnliche Kurzbeschreibungen
- betroffener Service oder CI-Familie
- wiederkehrende Assignment Group
- ähnliche Lösungsnotizen
- Reopen- oder Duplicate-Muster
- Alterung und SLA-Wirkung
Das Ziel ist keine perfekte maschinelle Klassifikation. Das Ziel ist eine überprüfbare Shortlist, die Problem Manager, Service Owner und ITSM-Leitung schnell bewerten können.
Prävention, Automatisierung oder Auto-Resolution
Wiederkehrende Incidents fallen meist in drei Maßnahmenpfade.
Prävention passt, wenn Nachfrage an der Quelle entfernt werden kann: zum Beispiel ein Joiner-Prozess, der Zugriffsfehler erzeugt, oder ein Standard-Build mit wiederkehrendem Defekt.
Automatisierung passt, wenn menschliche Triage repetitiv ist, aber noch Entscheidung nötig bleibt. Dazu gehören Anreicherung, Klassifizierung, Routing und Evidenzsammlung.
Auto-Resolution passt nur, wenn das Muster stabil, risikoarm und heute schon jedes Mal gleich gelöst wird.
Die Seite zur Ursachenanalyse für ITSM nutzt dieselbe Logik: RCA ist nur wertvoll, wenn Owner, Intervention und messbarer nächster Schritt klar sind.
Was ins Entscheidungs-Paket gehört
Ein Problem-Management-Paket sollte nicht jedes wiederholte Ticket auflisten. Es sollte die stärksten Chancen nach Wirkung und Sicherheit priorisieren:
- Name des wiederkehrenden Musters
- Evidenz aus Quelltickets
- betroffene Gruppen oder Services
- Volumen- und Verzögerungssignal
- empfohlener Maßnahmenpfad
- verantwortlicher Owner
- 90-Tage-Ziel
So kann Leadership Präventionsarbeit finanzieren, weil die Empfehlung auf Ticket-Evidenz basiert und nicht auf Meinung.
Nutzung im 90-Tage-Plan
Die ersten 30 Tage validieren die Top-Muster und klären Owner. Die nächsten 30 Tage entfernen einfache Wiederholnachfrage durch Routing, Knowledge oder Prozessänderungen. Die letzten 30 Tage prüfen, ob Volumen, Alterung und Weiterleitungen tatsächlich sinken.
Für Teams, die neue Tools prüfen, erklärt die Seite zu ITSM-Analytics-Software-Alternativen den Unterschied: Dashboards zeigen wiederkehrende Nachfrage, aber der fehlende Wert ist meistens Priorisierung.