Service Desk Analytics: Weiterleitungsquote und SLA-Risiko
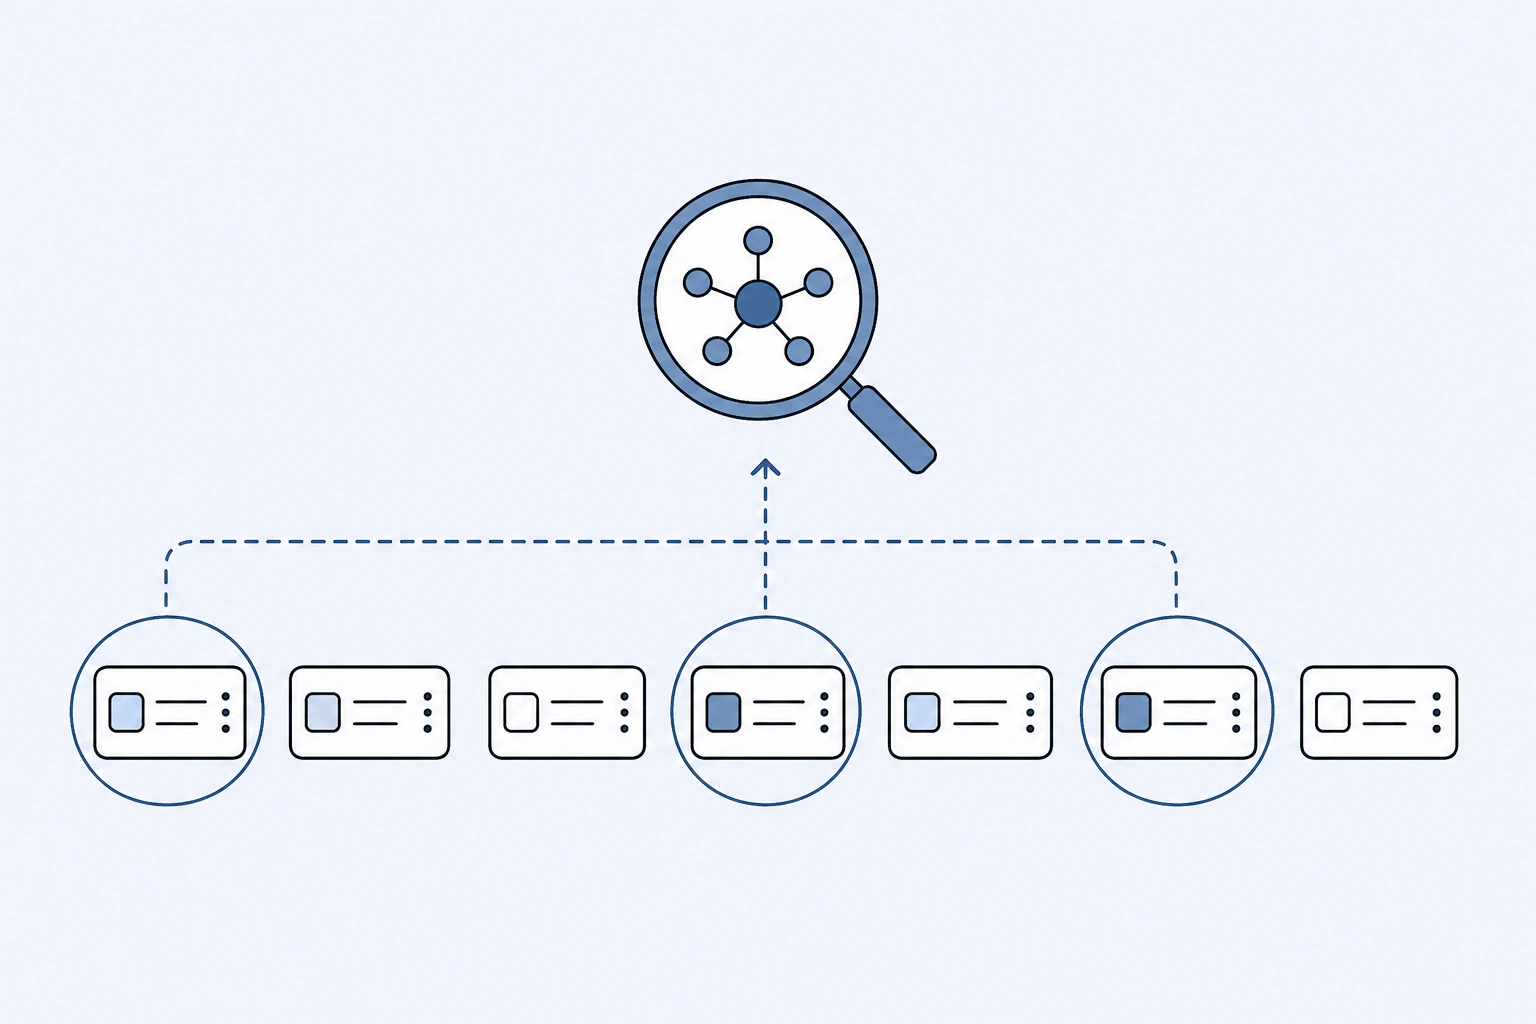
Die Weiterleitungsquote ist ein Kernsignal in Service Desk Analytics, wird aber oft wie eine Nebenmetrik behandelt. Jede zusätzliche Übergabe erhöht Wartezeit, Kontextverlust und das Risiko, dass SLAs aus strukturellen statt rein volumetrischen Gründen reißen.
Teams, die Weiterleitungen nach Queue-Grenzen verfolgen, erkennen schneller, wo das Support-Design Reibung erzeugt. Genau dort liefert ITSM-Reporting die Hinweise für bessere Triage-Regeln, klarere Service-Verantwortung und stabilere SLA-Leistung.
Warum Weiterleitungen SLA-Probleme vorhersagen
Jede Weiterleitung zeigt, dass das Ticket nicht sofort beim richtigen Owner gelandet ist. Eine einzelne Übergabe ist normal. Wiederholte Übergaben in denselben Kategorien sind meist ein strukturelles Problem.
Der SLA-Timer läuft weiter, während Teams klären, wer zuständig ist. Wenn der Verstoß im Dashboard sichtbar wird, ist die Ursache oft schon in mehreren Handoffs verschwunden.
Die Weiterleitungsquote ist deshalb kein isolierter Zähler. Sie ist ein Signal für unklare Routing-Regeln, schwache Kategorisierung, Ownership-Lücken und fehlendes First-Line-Wissen.
Was der Export zeigen sollte
Eine gute Analyse braucht Ticket-IDs, Eröffnungs- und Lösungszeitpunkte, Assignment-Group-Wechsel, Prioritäten, Kategorien und Statushistorie. Entscheidend ist nicht nur, wie oft weitergeleitet wird, sondern wo.
Suchen Sie nach:
- Kategorien mit hoher First-Touch-Fehlquote
- Gruppen, die viele Tickets erhalten und die meisten weitergeben
- Handoff-Paaren, die jede Woche wiederkehren
- Tickets, die altern, bevor echte Ownership entsteht
- Prioritäten, bei denen Weiterleitungen SLA-Verletzungen vorhersagen
Diese Analyse überschneidet sich mit der ITSM-Bottleneck-Analyse: Eine Gruppe kann schnell wirken, aber trotzdem Teil einer Schleife sein, die Kundenerfahrung und SLA-Leistung beschädigt.
Von der Kennzahl zur Maßnahme
Weiterleitungsdaten helfen nur, wenn daraus Entscheidungen entstehen:
- Routing verbessern: Assignment-Regeln für falsch landende Kategorien anpassen.
- Ownership klären: für unklare Service-Grenzen eine verantwortliche Gruppe bestimmen.
- Knowledge ergänzen: wiederholte Eskalationen mit First-Line-Anleitungen reduzieren.
- Automatisieren: Tickets klassifizieren oder anreichern, wenn immer derselbe Kontext fehlt.
- Steuern: Handoff-Schleifen wöchentlich prüfen, bis das Muster sinkt.
Die stärksten Kandidaten haben hohes Volumen und eine klare Maßnahme. Eine seltene Übergabe ist kein Leadership-Thema. Eine wiederkehrende Schleife zwischen zwei Gruppen in einer hochvolumigen Kategorie schon.
Wie man es an Führungskräfte berichtet
Zeigen Sie keine Liste aller weitergeleiteten Tickets. Zeigen Sie eine Rangfolge:
- Kategorie oder Service-Familie
- Handoff-Muster
- Volumen und Verzögerungssignal
- verantwortlicher Owner
- empfohlene Intervention
- erwarteter Effekt
Die Seite zu den besten ITSM-Reporting-Tools für Führungsteams macht denselben Punkt: Reporting ist erst wertvoll, wenn es Entscheidungen auslöst.
Was gut aussieht
Gute Analyse will nicht jede Weiterleitung eliminieren. Komplexe Services brauchen Eskalation. Das Ziel ist, vermeidbare Handoffs zu entfernen und notwendige Handoffs schnell und klar zu machen.